谢朝晔的碎碎念

Xiezhaoye
Xiezhaoye

Read, Thoughts, Notes.

  1. * 用户之所以忍受一套包含95%无用功能的软件,是因为为每个人单独开发工具太贵;
    * 下一代个人计算机的核心竞争力可能不是功能数量,而是可塑性。操作系统不再只是厂商提前完成、用户被动接受的产品,而会成为一个能通过自然语言不断修改、逐渐适应个人习惯的环境。
    https://mp.weixin.qq.com/s/Pxte7G7vOcwO_ThvQPEhJg
  2. https://www.aaron-gray.com/ai-and-chauffeur-knowledge/
    最近发表了一篇题为 《人工智能如何悄然削弱学习的乐趣与努力 》的评论文章。人们逐渐意识到的一点是,如果你使用人工智能来学习新事物,你可以比传统方法快得多地掌握知识,因为它非常擅长总结大量多样化的信息;但你的理解和记忆力却远不如传统学习方式,因为你学习的时间太短,而且你的大脑并没有积极参与到学习过程中。

    人类大脑的工作方式, 以螺旋式学习事物 是记忆它们的最佳方法之一。比如,学新东西。明天,稍微回顾一下这件事。3天后,再次回到话题。7天后,再稍微研究一下。3周后,再稍微研究一下。2个月后,再稍微研究一下。就像锻炼身体肌肉一样,这就是将某个主题巩固到记忆中的方法。

    但人工智能却完全绕过了这一过程,因为它只需为你进行调查和总结即可,随后你便可做出决定并继续前行。或许你做出的决策相当不错,但你却从未真正领悟其背后的细微差别与细节,因为你的大脑从未为此付出过努力。

    对于诸如研究一项购买决策之类的事情而言,这无疑是件好事。你能在短短几分钟内做出相当明智的选择,而无需耗费数天宝贵时间来深入研究。但对于关乎生计之类的事务而言,将所有细微差别与细节性工作都外包出去则是一个糟糕的主意,因为就像肌肉一样,大脑若长期不用便会萎缩和退化。

    与此形成对比的是阅读书籍,你在几个星期内不断回到同一个主题。或者是传统的软件工程,你沉浸在代码中,积极使用大脑学习事物的位置,并在数月和数年中每天一点点地将它们粘合在一起。
  3. 1. 蒸汽时代工厂底层约束(1800–1880)
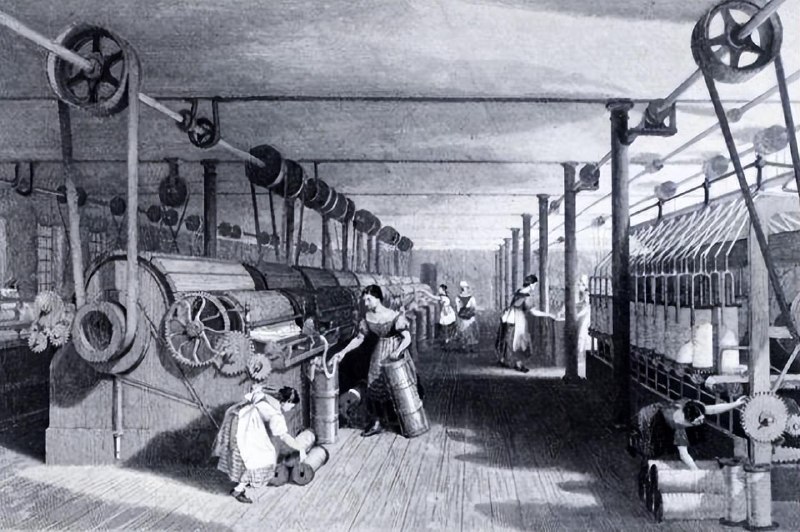
    第一次工业革命依靠中央蒸汽机驱动全厂:厂房中心安放一台巨型蒸汽主机,天花板贯穿一整根钢制传动轴,通过无数皮带、滑轮把动力分给每台机床。
    厂房必须建成多层狭长结构:传动轴越长动力损耗越大,机器必须沿着传动轴一字排开;
    生产布局服从动力传输,而非物料加工流程:不管工序顺序,离主轴近的设备放前排,物料来回搬运浪费大量工时;
    传动损耗极高、容错极低:主轴一故障,整座工厂全线停工;皮带摩擦常年损耗 30%–50% 能源。

    2. 第一代电气化:单纯替换动力(1880–1910,效率毫无提升)
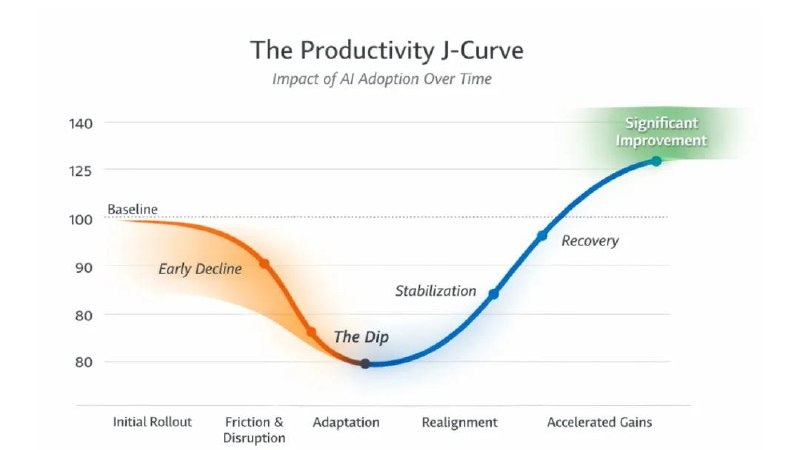
    1882 年商用电力落地,工厂主最简单的改造方案:拆掉中央蒸汽机,原地换一台大功率集中电机,传动轴、皮带、厂房布局、生产线流程、管理制度完全照搬蒸汽时代,没有任何重构。
    结果:
    动力损耗、厂房动线、停工风险、物料浪费全部保留;
    只是燃料从煤炭换成电费,生产成本小幅下降,但整体劳动生产率几乎没有增长;
    1890–1920 三十年,美国制造业全要素生产率长期平缓,电力普及没有带来预期爆发式增长,形成著名的电气化生产率悖论。

    3. 真正释放电力红利:全盘重构工厂(1910–1920 年代)
    企业家与工程师终于意识到电力的核心优势:分布式独立驱动(单元驱动 Unit Drive),不再需要统一传动轴。全面改造包含三层变革:
    动力底层重构:取消全屋传动轴,每一台机床单独搭载小型电动机,设备独立启停、互不干扰,彻底消除皮带传动损耗;
    厂房彻底重设计:抛弃多层狭长建筑,改用单层开阔厂房;机器不再围绕动力轴排布,完全按照产品加工工序流水线摆放,物料单向流动,大幅削减搬运浪费;
    配套组织与管理革新:
    分区供电、分段生产,局部停机不影响全厂;
    车间照明独立电气化,夜班规模化生产;
    全新流水线管理、标准化分工、工人技能重新培训、配套库存与调度制度重建。
    完成全套重构后,美国制造业生产率迎来爆发:1899–1929 制造业效率提升近 50%,电力密集行业涨幅遥遥领先,流水线、大规模量产(福特制)同步成熟,第二次工业革命的经济价值才真正兑现。
  4. 刚看到新闻,在Google工作并获得诺贝尔奖的John Jumper刚宣布加入Anthropic。 用AI查了一下,最近半年跳槽到Anthropic的牛人非常多,包括:Karpathy,Nordeen。。。。。。有一种大家都挤着进Anthropic的感觉。为何Anthropic对顶级人才有如此大的吸引力?

    Anthropic最新的Fable受到很多人的抨击:顶级模型只给少数合作伙伴先使用,检测到普通询问一些敏感的问题时会拒绝服务,会保留用户提问记录30天等等。美国 9号以“可越狱突破安全护栏”为由下发紧急出口管制令。大家都嘲笑Anthropic搬石头砸自己的脚。

    会不会因为达里奥传达出:坚信AGI很快会到来,也真的把安全放在重要的位置,这种对外宣传恰好迎合了这些顶尖人才的想法。甚至传闻Anthropic的员工坚信自己做的事情是替AI“接生”。
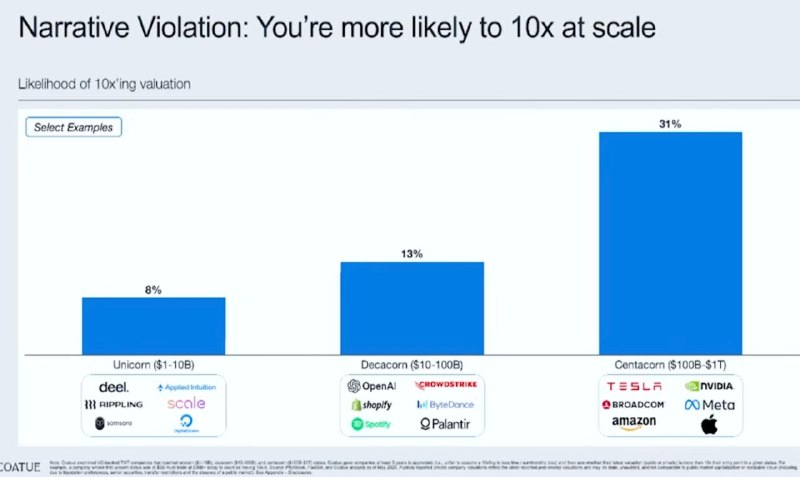
  5. 独角兽 Unicorn(估值 10 亿–100 亿美元):仅 8% 的概率实现 10 倍估值增长;
    举例:deel、Rippling、Scale、Applied Intuition 等初创独角兽。

    十角兽 Decacorn(估值 100 亿–1000 亿美元):概率提升至 13%;
    举例:OpenAI、字节跳动、Shopify、CrowdStrike、Spotify、Palantir。

    百角兽 Centacorn(估值 1000 亿–1 万亿美元):概率大幅拉高至 31%,是独角兽近 4 倍;
    举例:特斯拉、英伟达、苹果、亚马逊、Meta、博通。
  6. 马斯克:通过ai我们将会创造丰富的物质,人民不再需要工作。(高情商)

    达里奥:随着ai的发展,我们将推动GDP创新高,同时会有极高的失业率。(低情商)
  7. 前几天在看llm训练流程时,想到一个问题,如果一些小语种,在互联网上的语料很少,印刷的书籍也很少(总之就是相关高质量的文字内容很少),这个情况下llm会不会有比较差的结果?

    搜了一下后真的存在这个问题。例如缅甸语,因为纯的缅甸语资料很少,所以当你用缅甸语和llm交互时,只做词语 / 短句映射、无深层逻辑、无本土专有知识、不用复杂推理时,效果还行,因为靠跨语言翻译迁移就能搞定。但是遇到:编程 / 法律 / 医疗 / 学术这四个领域,llm给出的回答质量就会很差。

    有类似问题的国家/语言有:柬埔寨-高棉语,老挝语,尼泊尔语,不丹-总卡语,阿富汗,斯里兰卡,埃塞俄比亚,尼日利亚,吉尔吉斯斯坦,格鲁吉亚,冰岛,马耳他,立陶宛。